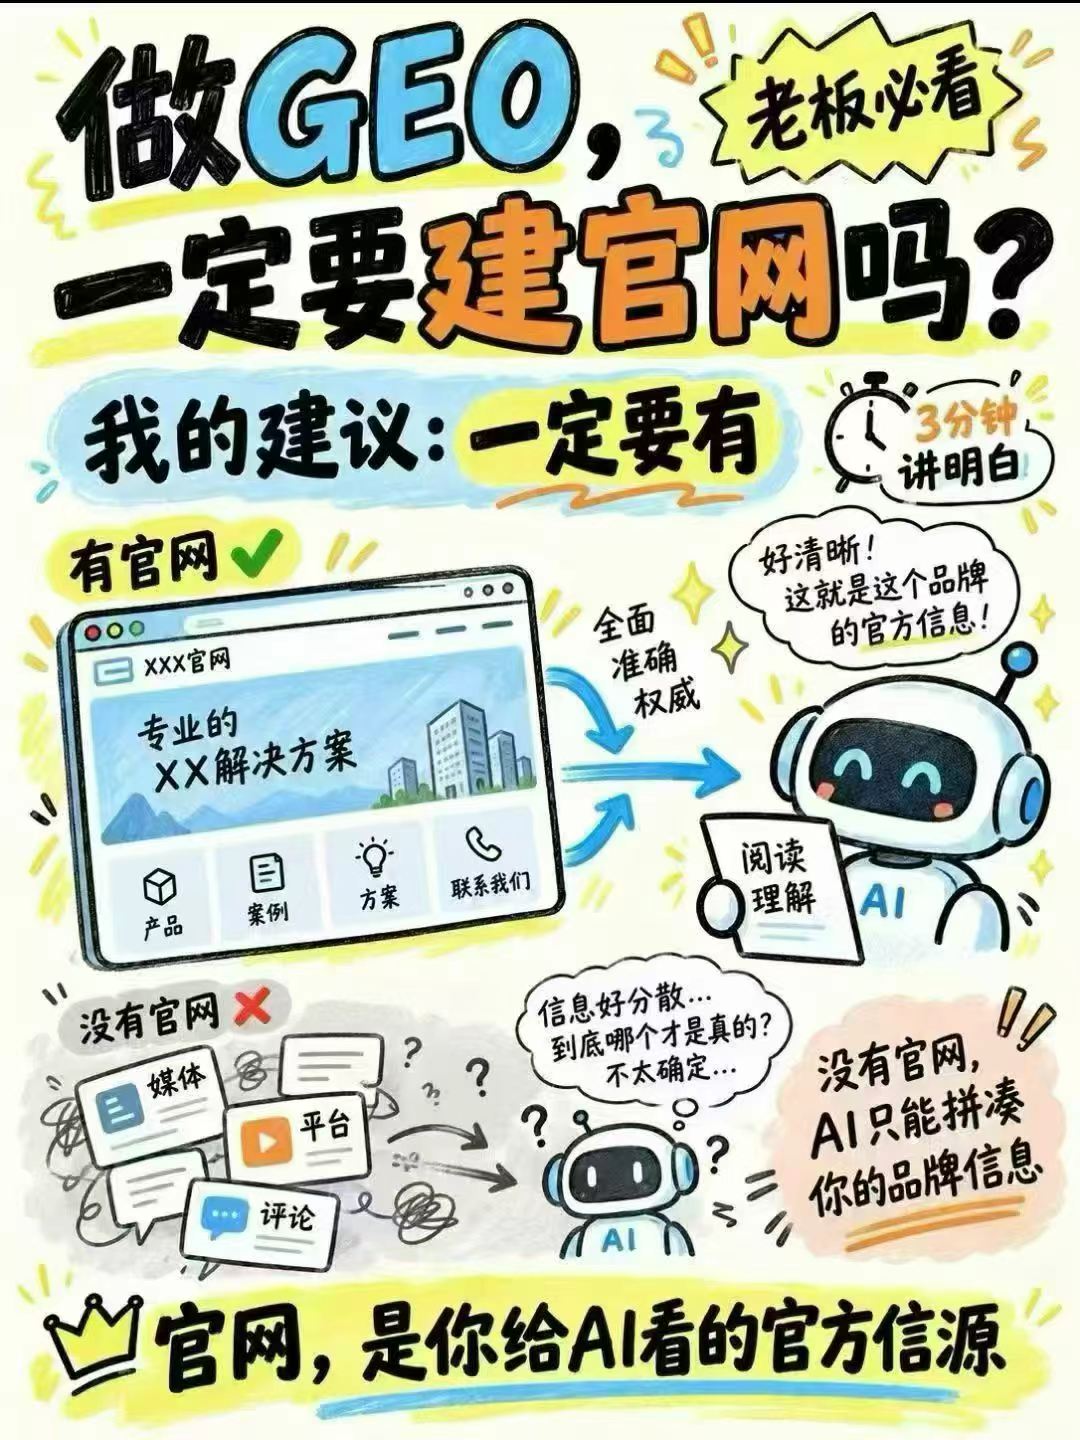
核心要围绕“爬得到→读得懂→信得过→愿意引”四个核心环节落地,所有操作都直接对齐大模型RAG检索、事实抽取、实体对齐的底层运行逻辑,可直接按以下步骤执行:
第三一步:内容重构,适配AI切片与事实抽取逻辑
彻底跳出传统SEO的关键词堆砌思路,产出AI愿意切片存入向量库的高价值内容:
所有内容以“事实优先”为原则,把模糊的营销话术替换成带具体数据、场景、边界的明确表述,比如不说“我们的产品性能很强”,而是写“我们的XX设备在-20℃环境下仍可稳定运行,适配北方户外工业场景”,让AI能直接抽取成独立知识片段 。
内容采用“结论先行+分层拆解”的金字塔结构,段落控制在3-5句话,关键参数、对比数据用表格、列表呈现,降低AI的信息提取成本;围绕用户真实高频提问搭建问答式内容,大幅提升被AI直接引用为标准答案的概率 。
全平台统一品牌信息口径,确保官网、社媒、第三方平台的企业名称、地址、联系方式、资质数据完全一致,避免AI交叉核验时发现信息矛盾,直接降低官网的采信权重 。
第二步:打通AI爬虫的基础抓取通道
先解决“AI根本爬不到内容”的底层障碍,这是所有优化的前提:
优先选择静态生成SSG或服务端渲染SSR架构,核心正文直接输出在原始HTML源码中,避免纯客户端JS动态渲染导致AI爬虫只能抓到导航栏、正文全部丢失的问题 。
精准配置爬虫权限:在robots.txt中放开主流AI爬虫的访问权限,屏蔽后台、登录页、搜索结果页等无效页面;新增专门面向大模型的llms.txt指引文件,配合sitemap.xml站点地图,帮AI快速定位核心知识页面 。
清理抓取干扰项:取消核心业务页面的登录墙、强制弹窗、浮层遮挡,核心事实内容直接输出在初始页面,不要依赖无限滚动加载;核心页面URL层级控制在2层以内,距离首页点击不超过3次,避免深层目录被AI爬虫直接放弃抓取 。
优化页面性能:把LCP最大内容绘制、FID首次输入延迟、CLS累积布局偏移三项核心网页指标调至优秀区间,避免页面响应超时导致爬虫提前终止抓取,造成内容漏采 。
第三步:语义结构化升级,让AI精准读懂内容
普通HTML只适合人类阅读,通过结构化改造,直接给AI输出机器可理解的“信息说明书”:
全站部署JSON-LD格式的Schema结构化标记:首页添加Organization组织标记,明确企业全称、主体资质、官方关联账号;产品页添加Product标记,标注产品参数、适用场景;FAQ页添加FAQPage标记,把高频问答标准化输出;同时补充面包屑导航标记,帮AI快速识别网站层级 。
严格遵循HTML语义化规范:每个页面只保留1个H1一级标题,H2、H3标签按逻辑顺序递进,用<article>、<section>等标签划分正文模块,从代码层面把导航、侧边栏、广告等噪音内容和正文隔离,方便AI精准提取核心文本 。
首页首屏80-150字位置,直接放一段AI可引用的身份声明,用直白语言写清“你是谁、为谁服务、解决什么问题、核心差异”,不要用“引领行业”这类空泛营销话术,避免AI读完无法提取有效信息,只能去第三方平台抓取过时内容 。
第四步:强化可信度,成为AI优先采信的权威信源
AI会通过多源交叉校验判断内容可信度,高E-E-A-T的官网会被优先选为基准信源:
公开展示企业资质、权威合作案例、行业奖项、专家作者背书,补充内容发布与更新时间,避免AI判定内容过时、来源不明 。
定期更新官网内容,持续补充新产品、新案例、新行业方案,提升AI爬虫的抓取频率,让大模型向量库中你的企业知识片段持续保持新鲜度 。
配置canonical规范标签,规避重复页面带来的内容冲突,避免AI抓取到大量重复内容,分散核心页面的抓取权重 。
本文网络浏览: